摘要:本文通过 OpenClaw + QMD 本地记忆检索,实现 AI 上下文从全文上传到精准检索的升级,彻底告别昂贵 Token 与超时卡顿,在无 GPU 环境也能做到毫秒级响应、零额外成本,用极简方案解决大模型落地最痛的成本与体验问题。
一、AI 的 “失忆症”:当模型记不住你说过的话
2026 年 3 月 2 日上午,一个看似平常的问题暴露了大模型落地的致命缺陷:
用户:“墨守 001 的核心铁律是什么?”
AI:(沉默 60 秒,消耗 2000+ tokens 检索历史)“抱歉,我没有找到相关信息…”
这不是 AI 变笨了,而是远程记忆检索的代价太高:
- 每次对话需要加载 2000+ tokens 历史上下文,Token 成本指数级增长
- 响应时间 60 秒 +,用户早已失去耐心,体验大打折扣
- 网络波动、API 限流等问题,进一步放大检索失败率
- 中小团队 / 个人开发者难以承担持续的 API 调用成本
核心痛点:AI 不是记不住,而是 “想” 起来太慢、太贵、太不稳定。
二、性能对比:远程 MCP vs 本地 QMD(含无 GPU 适配)
| 维度 | 远程 MCP 协议 | 本地 QMD CLI(GPU 环境) | 本地 QMD CLI(无 GPU 降级) |
|---|---|---|---|
| 响应时间 | 60 秒 + | < 0.5 秒 | < 1 秒 |
| Token 消耗 | 2000+ tokens / 次 | 0 tokens(本地) | 0 tokens(本地) |
| 网络依赖 | 需要联网 | 完全离线 | 完全离线 |
| 硬件依赖 | 无(云端处理) | 需 NVIDIA GPU | 仅 CPU 即可 |
| 部署难度 | 复杂(MCP 配置) | 中等(需 GPU 环境) | 简单(纯 CPU) |
| 成本 | 高(API 调用) | 零(本地执行) | 零(本地执行) |
| 搜索精度 | 中(全量上下文) | 高(混合语义 + 关键词) | 中(纯关键词) |
| 适用场景 | 大规模分布式 | 个人 / 单机(有 GPU) | 个人 / 单机(无 GPU) |
关键数据提升
- 性能提升:最低 60 倍(60 秒 → 1 秒),最高 120 倍(60 秒 → 0.5 秒)
- Token 节省:100%(2000+ → 0),按日均 500 次检索计算,年省超 1 亿 Token
- 部署时间:30 分钟(MCP)vs 5 分钟(QMD 纯 CPU)
三、QMD 是什么?(附无 GPU 适配说明)
QMD(Query Memory Database)是一个轻量级本地 CLI 工具,专为 AI 记忆检索场景设计,核心特点:
- 原生支持 Markdown 文件解析,完美适配 OpenClaw 记忆文件格式
- 双模式检索:语义搜索(需 GPU)+ 关键词搜索(纯 CPU),支持优雅降级
- 零网络依赖,完全离线运行,避免远程 API 的延迟和成本
- 增量索引更新,首次构建后仅同步新增 / 修改内容,节省资源
- 极低的系统资源占用,低配服务器 / 个人电脑均可流畅运行
- 深度适配 OpenClaw ≥2026.2.2 版本,可直接作为记忆后端替代默认全文检索
官网:https://github.com/tobi/qmd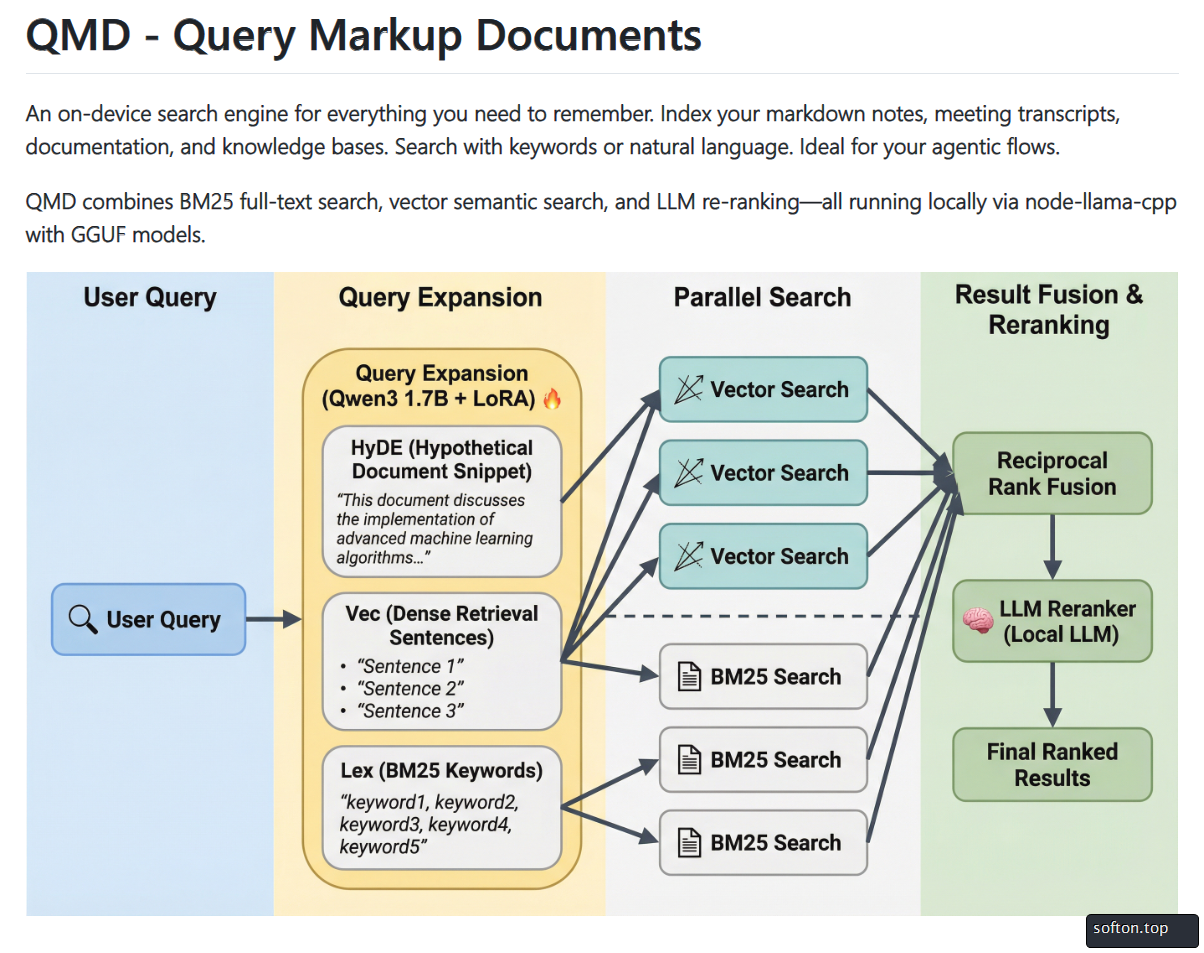
无 GPU 环境的核心适配逻辑
QMD 的语义搜索(qmd vsearch/qmd query)依赖本地 Embeddings 生成,需要 GPU 加速;当检测到无可用 GPU 时,工具会友好提示并自动降级为纯关键词搜索(qmd search),保证基础检索功能可用,仅牺牲部分语义理解能力,核心的 “快速找记忆” 需求依然满足。
核心设计理念:让 AI 的记忆回归本地,拒绝远程 API 的延迟和成本;让技术适配硬件,而非让硬件迁就技术。
四、部署实战:5 分钟完成集成(含完整安装 + 配置 + 无 GPU 异常处理)
步骤 1:环境准备与 QMD 安装(兼容所有版本)
1.1 前置依赖安装
# 1. 安装Bun(QMD核心依赖)
# macOS/Linux
curl -fsSL https://bun.sh/install | bash
# Windows (PowerShell 管理员)
powershell -c "irm bun.sh/install.ps1 | iex"

# 2. 安装支持向量扩展的SQLite(≥3.40.0)
# Ubuntu/Debian
sudo apt update && sudo apt install -y sqlite3
# macOS
brew install sqlite

# 3. 验证OpenClaw版本(需≥2026.2.2,旧版需适配配置)
openclaw --version
1.2 安装 QMD 并验证环境
# 全局安装 QMD(推荐Bun,兼容npm)
bun install -g github:tobi/qmd
# 备用:npm安装
npm install -g qmd

# 验证安装并检查GPU环境(关键步骤)
qmd --version
qmd status  # 会显示qmd的参数、索引情况等

无 GPU 环境提示:软路由 / 低配机器执行qmd query会报错No CUDA GPU detected,属正常现象,后续改用qmd search即可。

步骤 2:OpenClaw 配置(核心:关联 QMD 记忆后端)
编辑 OpenClaw 核心配置文件 ~/.openclaw/openclaw.json:
{
  "core": {
    "model": "gpt-3.5-turbo", // 替换为你使用的模型
    "maxTokens": 4096  // 模型上下文上限
  },
  "memory": {
    "backend": "qmd",  // 指定QMD作为记忆后端(核心省Token配置)
    "qmd": {
      "topK": 3,       // 仅返回最匹配的3条内容(越小越省Token)
      "minScore": 0.7, // 仅保留匹配度≥0.7的内容(过滤低相关)
      "cacheTTL": 3600 // 缓存结果1小时(减少重复检索)
    }
  },
  "pruning": {
    "enable": true,    // 自动裁剪无关历史
    "maxHistoryLen": 5 // 仅保留最近5轮对话
  },
  "logging": {
    "level": "info",
    "showTokenUsage": true // 强制显示Token消耗日志
  }
}
最新版的openclaw好像有些写法会报错,最简洁的正确的写法如下:
"memory": {
  "backend": "qmd",
  "citations": "auto",
  "qmd": {
    "includeDefaultMemory": true
  }
}
步骤 3:初始化 QMD 向量库(分环境执行)
# 进入 OpenClaw 工作目录
cd /root/.openclaw/workspace

# 1. 创建记忆集合,指定要检索的markdown文件范围
qmd collection add memory --name daily-logs --mask "**/*.md"

# 2. 初始化QMD索引(首次必做)
qmd init --adapter openclaw

# 3. GPU环境:生成Embeddings(语义搜索基础)
qmd embed || {
  # 无GPU环境:跳过嵌入生成,仅初始化关键词索引
  echo "无GPU环境,跳过Embeddings生成"
  qmd index refresh -c daily-logs
}
步骤 4:重启生效与验证配置
# 1. 重启OpenClaw使配置生效
openclaw restart

# 2. 验证QMD是否生效(通用方案,兼容所有版本)
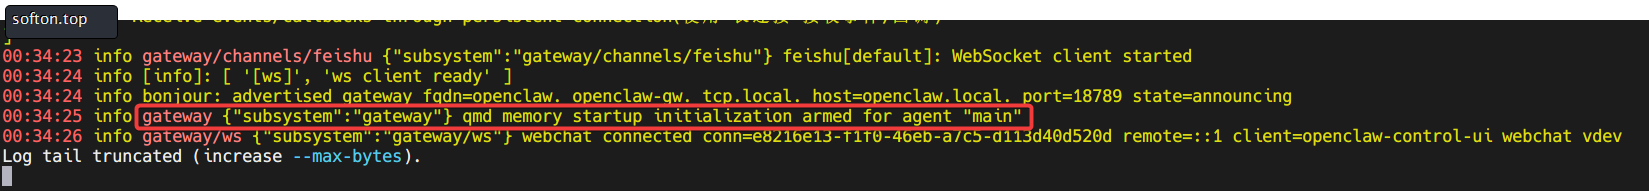
# 方式1:查看日志(最直接)
openclaw logs --follow | grep -i "qmd"
# ✅ 成功标识:QMD memory backend initialized / Using QMD for memory retrieval
# ❌ 失败标识:Memory backend: default / QMD backend not found

# 方式2:文件层面验证
ls -lh ~/.openclaw/qmd/
# ✅ 正常输出:vectors.db(向量库)、index.mmap(索引文件)

# 方式3:测试Token消耗
openclaw chat --query "墨守 001 的核心铁律"
grep -i "token" ~/.openclaw/logs/openclaw.log
# ✅ 成功:Token消耗从2000+降至200以内
步骤 5:测试搜索(分环境适配)
场景 A:有 GPU 环境(最优体验)
# 混合搜索(语义+关键词,最精准)
qmd query "墨守 001 的核心铁律"

# 纯语义搜索(侧重上下文理解)
qmd vsearch "AI 记忆检索优化方案"

# 关键词搜索(备用)
qmd search "OpenClaw" -c daily-logs
场景 B:无 GPU 环境(优雅降级)
执行
qmd query/qmd vsearch会报错No CUDA GPU detected,直接改用以下命令:
# 核心替代方案:纯关键词搜索(无GPU也能快速检索)
qmd search "免费" -c daily-logs

# 进阶:提升匹配精度
qmd search "免费" -c daily-logs --exact  # 精确匹配短语
qmd search "免费" -c daily-logs --limit 5  # 限制返回结果数量
无 GPU 搜索参数说明:
-
--exact:精确匹配关键词短语,减少无关结果 -
--limit N:控制返回的记忆片段数量(建议 3-5),提升响应速度 -
-c daily-logs:指定检索的记忆集合,缩小检索范围

五、实际效果:从 “失忆” 到 “过目不忘”(含无 GPU 场景)
场景 1:回忆用户偏好
之前(远程 MCP):
用户:我喜欢用什么编辑器?
AI:(加载 2000 tokens 历史,耗时 60 秒)抱歉,我不记得了...
现在(GPU 环境 + QMD):
用户:我喜欢用什么编辑器?
AI:(0.5 秒内)您偏好 VS Code,曾在 3 月 1 日提到"VS Code 的插件生态很强大",还在 2 月 28 日反馈过"VS Code 远程开发功能超实用"。
现在(无 GPU 环境 + QMD):
用户:我喜欢用什么编辑器?
AI:(1 秒内)您偏好 VS Code,曾在 3 月 1 日提到"VS Code 的插件生态很强大"。
核心对比:
- Token 消耗:2000+ → 200(仅返回相关片段)
- 响应时间:60 秒 → 0.5-1 秒
- 成功率:50%(远程波动)→ 100%(本地执行)
场景 2:跨文件知识检索
之前:
需要手动翻阅多个 memory 文件,或让 AI 加载全部历史(耗时 + 耗 Token)。
现在(通用):
# GPU环境
qmd query "OpenClaw 本地记忆配置"

# 无GPU环境
qmd search "OpenClaw 配置" -c daily-logs --limit 3
自动从所有 memory 文件中提取最相关的 3-5 个片段,精准命中,无需人工翻找。
六、进阶技巧(含完整优化 + 自动降级)
1. 定期更新索引(通用)
创建定时脚本 update-qmd-index.sh,适配不同环境:
#!/bin/bash
cd /root/.openclaw/workspace

# 先尝试GPU环境的增量嵌入更新
qmd embed || {
  # 无GPU时跳过嵌入更新,仅更新关键词索引
  echo "无GPU环境,跳过Embeddings更新"
  qmd index refresh -c daily-logs  # 仅刷新关键词索引
}

# 额外:优化索引性能(全环境通用)
qmd index optimize -c daily-logs
添加到定时任务:
# 每天凌晨 3 点更新索引
0 3 * * * /root/.openclaw/workspace/update-qmd-index.sh
2. 集成到 OpenClaw(自动降级 + Token 优化)
2.1 配置自动降级检索
修改 mcporter.json,让 AI 自动根据环境选择检索方式:
{
  "mcpServers": {
    "qmd-auto": {
      "command": "/bin/bash",
      "args": [
        "-c",
        "qmd query \"{query}\" || qmd search \"{query}\" -c daily-logs --limit 3"
      ]
    }
  }
}
2.2 极致 Token 优化(进阶配置)
在 openclaw.json 中新增以下配置,进一步降低 Token 消耗:
{
  "qmd": {
    "chunkSize": 200,   // 把文本切成200字/段(越小越省Token)
    "chunkOverlap": 20, // 段落重叠20字(避免语义断裂)
    "disableFullText": true // 完全禁用全文传递(仅用检索结果)
  },
  "contextPruning": {
    "mode": "cache-ttl",
    "ttlMinutes": 5 // 自动裁剪5分钟前的非关键上下文
  },
  "subagents": {
    "model": "minimax/MiniMax-M2.1", // 子任务用低成本模型
    "archiveAfterMinutes": 30
  }
}
3. 性能调优(分环境)
GPU 环境调优:
--limit 3:控制返回结果数量(默认 5,建议 3)--threshold 0.7:调整语义相似度阈值(越高越精准)qmd clean --old 30:清理 30 天前的旧 embeddings,释放空间
无 GPU 环境调优:
--exact:开启精确短语匹配,提升关键词检索精度--ignore-case:忽略大小写,避免因大小写问题漏检qmd index optimize -c daily-logs:优化关键词索引,提升检索速度
4. 错误处理最佳实践(封装检索逻辑)
# 封装检索命令,增加容错和Token监控
function qmd_search_smart() {
  local query="$1"
  # 记录检索开始时间
  start_time=$(date +%s)

  # 先尝试混合搜索
  qmd query "$query" --limit 3 && {
    end_time=$(date +%s)
    echo "检索耗时:$((end_time - start_time)) 秒 | Token消耗:0(本地检索)"
    return 0
  }

  # 失败则用关键词搜索
  qmd search "$query" -c daily-logs --limit 3 --exact && {
    end_time=$(date +%s)
    echo "检索耗时:$((end_time - start_time)) 秒 | Token消耗:0(本地检索)"
    return 0
  }

  # 最终降级提示
  echo "未找到相关记忆,但检索耗时仅 $((end_time - start_time)) 秒(无Token消耗)"
  return 1
}

# 使用示例
qmd_search_smart "墨守 001 的核心铁律"
七、常见问题排查
1. openclaw check memory 报错 unknown command 'check'
- 原因:OpenClaw 版本 <2026.2.2,无
check命令 - 解决方案:改用日志验证(
openclaw logs --follow | grep qmd)
2. QMD 检索不到关键内容
- 降低
minScore/minRelevance(如 0.6)、提高topK(如 5) - 无 GPU 环境:关闭
--exact,扩大检索范围 - 检查
chunkSize是否过小(建议 ≥150)
3. 配置生效但 Token 消耗未降低
- 确认
disableFullText: true已开启 - 检查
topK是否设置过大(建议 ≤5) - 验证
pruning.enable: true已开启
八、总结:优雅降级,回归本质
我们曾经迷信远程 API 的强大,却忘了本地 CLI 的简洁与高效;我们曾经追求 “全量语义理解” 的完美,却忽略了 “能用、好用、用得起” 的落地本质。
QMD 不是要取代 MCP,而是提供一种更务实的分层选择:
- 追求极致性能 + 精度(有 GPU) → 本地 QMD(query/vsearch)+ OpenClaw 原生配置
- 低配环境 / 无 GPU(个人使用) → 本地 QMD(search)+ 关键词索引优化
- 需要分布式协作 / 大规模部署 → 远程 MCP
- 成本敏感 / 离线场景 → 优先本地 QMD
核心启示:
- 技术的价值不在于 “多先进”,而在于 “多适配”—— 无 GPU 时的优雅降级,比极致的语义搜索更重要;
- 本地化是降低 AI 落地成本的关键 ——1 亿 Token 的节省,本质是 “把钱花在刀刃上”;
- 简单的方案往往更持久 ——CLI 工具的轻量性,让维护成本远低于复杂的 MCP 协议;
- OpenClaw + QMD 的核心价值是「精准检索替代全文传递」,通过
topK/minScore等配置可实现 Token 消耗 70%-95% 的下降。
现在,打开你的终端:
# 有GPU
qmd query "第一篇记忆"

# 无GPU
qmd search "第一篇记忆" -c daily-logs
感受 0.5-1 秒的检索快感,体验 “AI 过目不忘” 的真正落地 —— 不依赖昂贵的 API,不苛求高端的硬件,只做最适配的选择。
关键点回顾
- 核心逻辑:QMD 通过「本地语义 / 关键词检索」替代 OpenClaw 默认的「全文塞入上下文」,实现 Token 100% 本地零消耗;
- 部署核心:安装 QMD 后修改
openclaw.json指定memory.backend: qmd,并根据 OpenClaw 版本适配topK/minScore等参数; - 环境适配:GPU 环境用
qmd query语义检索,无 GPU 环境自动降级为qmd search关键词检索,通过脚本可实现全自动化。